
漫剧跟真人短剧不是一回事,观众读的是格子里的信息:谁在说话、情绪是什么、视线往哪走。第一次做的时候我把分镜脚本直接甩给模型,画面挺漂亮,但格与格之间根本读不懂——上一格人还在门口,下一格就到厨房了,中间全靠脑补。
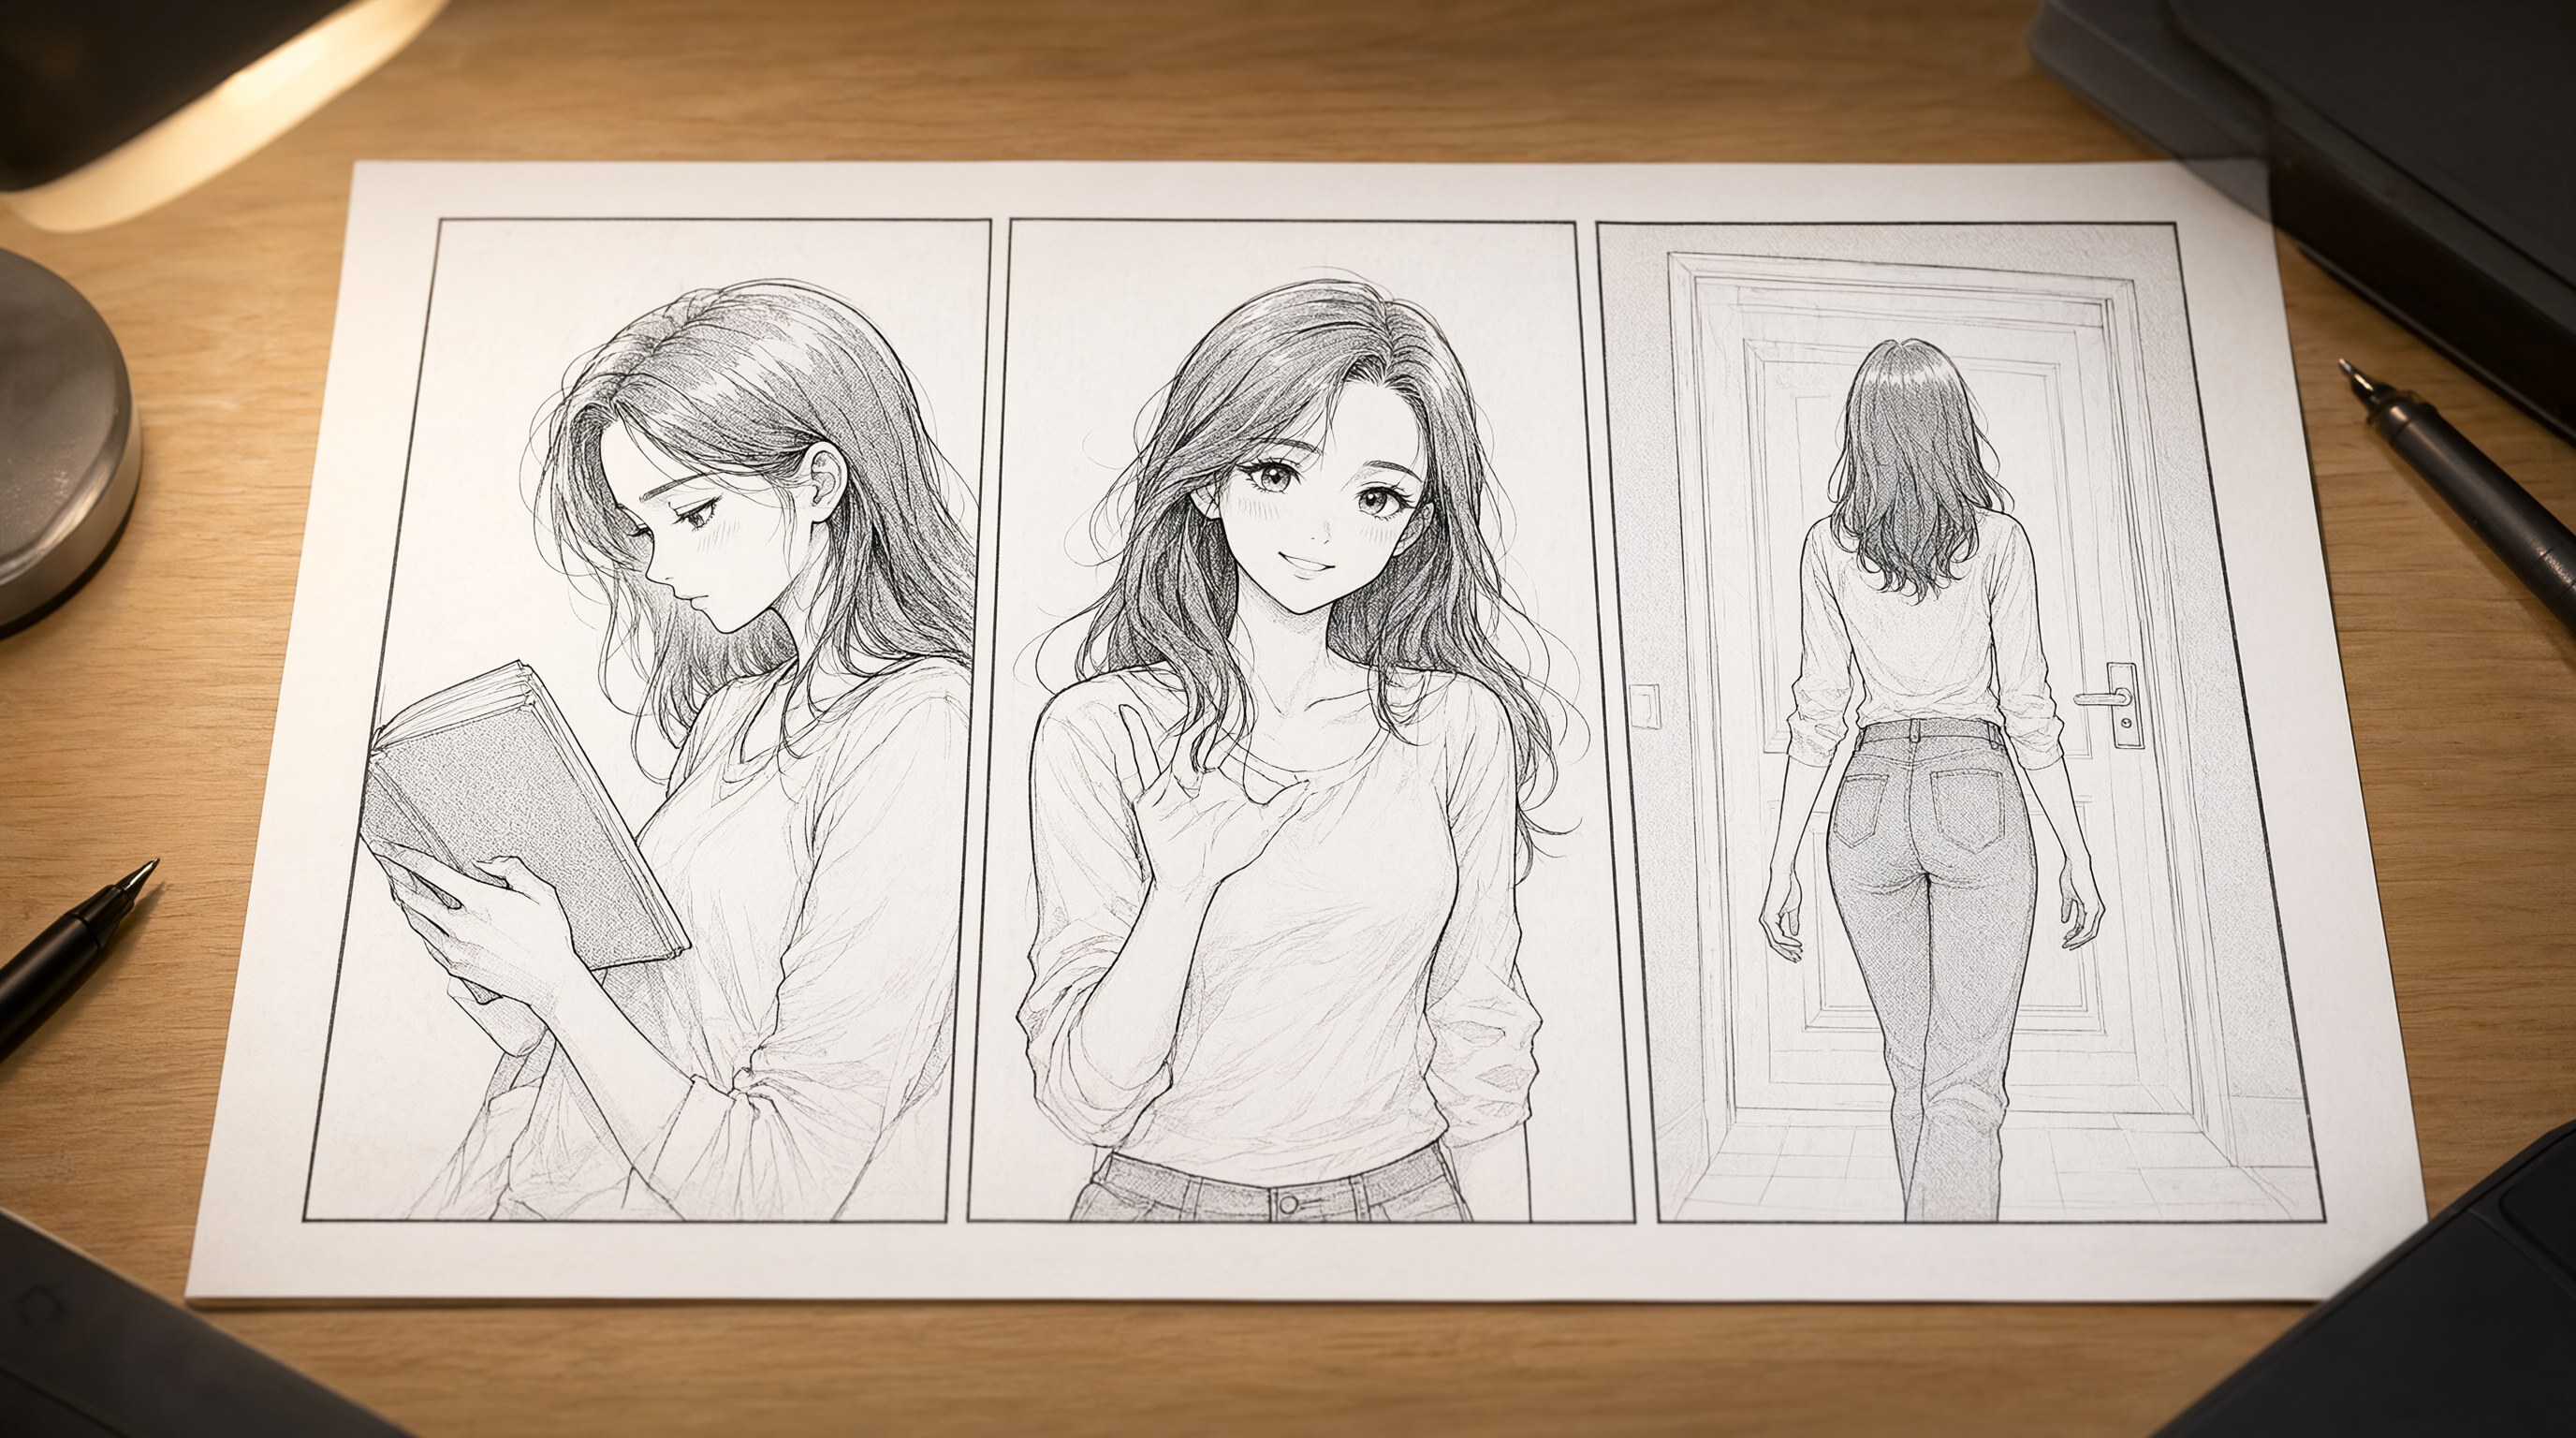
分格还是得自己排。我先手绘一张 1×3 或 2×2 的格子草图,把每格的景别定死:大远景交代环境,中景讲动作,特写放大情绪,再让模型逐格生成。这样拼起来叙事才连贯,也省掉大量废片。
线稿一致性最难。模型每次都会重新理解人物,头发长短、衣服褶皱都能飘。我后来固定三视图参考加同一段外观描述,只改动作和表情,人物才稳下来。黑白漫的网点更得盯着,模型喜欢自作主张加渐变,网点一糊就没有漫画味了。
气泡和对白千万别交给生图模型,它给的字九成是乱码。我的做法是后期单独排版气泡和拟声词,配音先做好再对时间轴。一集控在六到八格最舒服,观众跟得上,制作成本也不会失控。



没有回复内容