

服务器调试和家用电脑调试完全是两个工种。家用电脑出问题,大不了重启、重装、送修;服务器出问题,业务跟着断,很多操作不可逆,而且人往往不在机房边上,隔着一条远程连接操作,一个手滑就能把自己锁在门外。带过几个刚接手服务器的同事,把最容易吃亏的地方和排查套路整理一下。
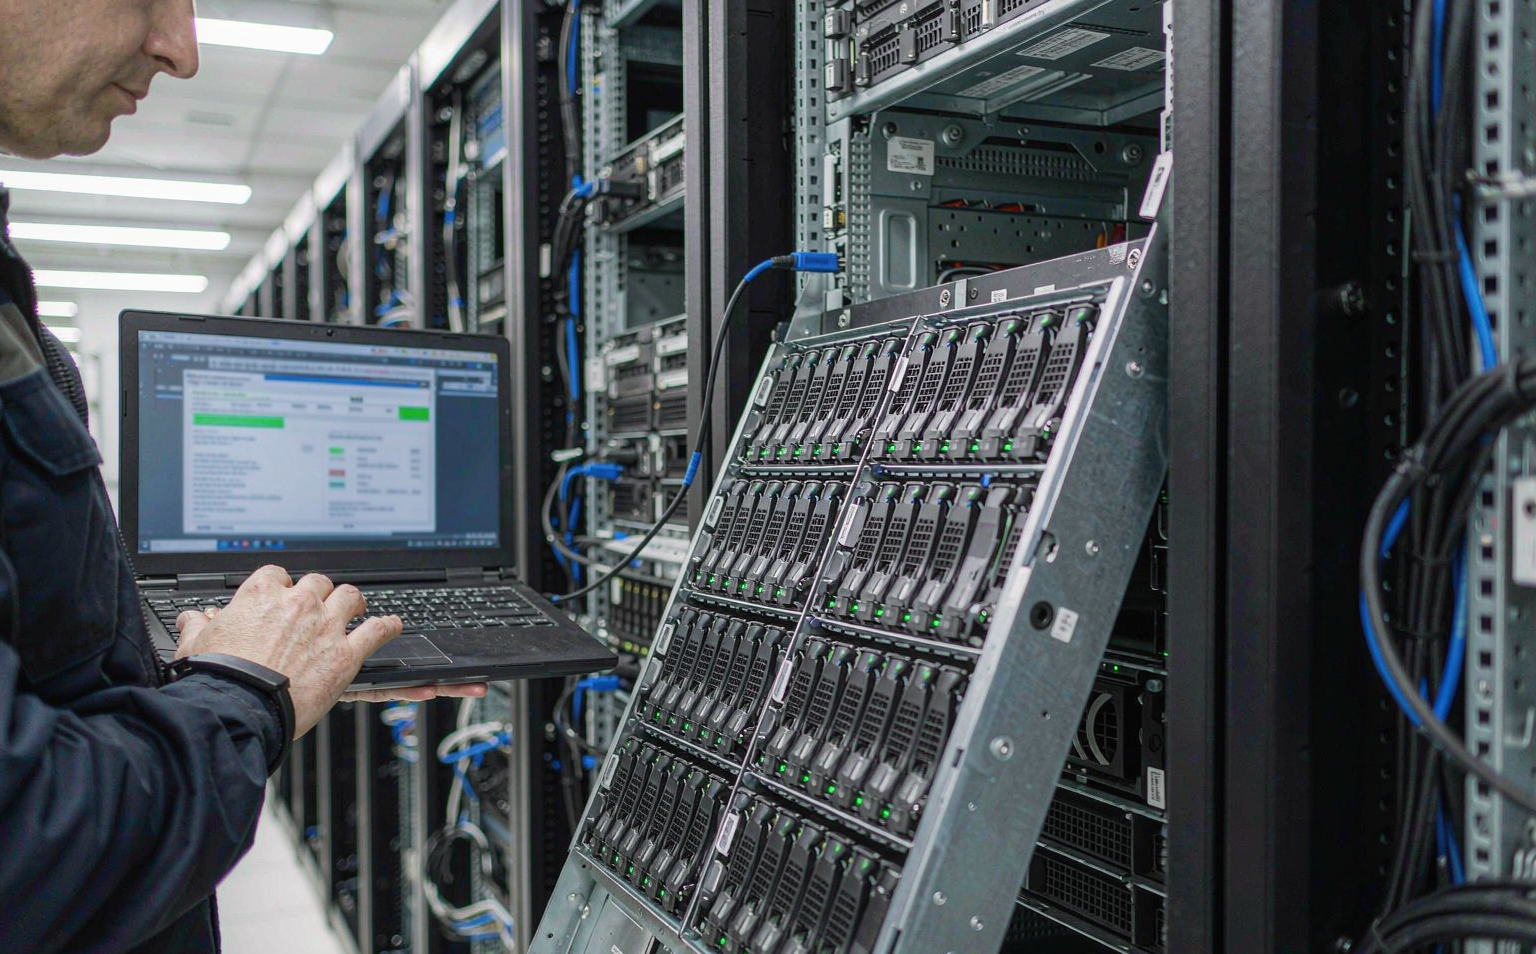
一、接手一台服务器,先摸清三条命脉
第一条是带外管理口,戴尔的 iDRAC、惠普的 iLO 或者通用 IPMI,先把它的地址、账号确认好——系统挂死的时候,只有这条路能进;第二条是电源和 RAID 状态,开机进 RAID 卡看一眼阵列是不是 Optimal,有没有降级重建,别带着隐患跑业务;第三条是固件版本,太老的固件翻车率高,但升级固件本身就是高风险操作,要在业务窗口做、做好失败回退准备。
二、远程操作的保命习惯
这是服务器调试和本地调试最大的区别。改 SSH 配置或者防火墙规则之前,先开第二个会话,旧连接别断,新规则确认能连上再退出旧会话;长耗时命令一律放在 tmux 或者 screen 里跑,SSH 一断任务就没了这种事谁都遇到过;高危操作前先拍快照或者确认备份可恢复,”备份没验证过等于没有备份”;再有就是把操作记录下来,改了什么、几点改的、怎么回滚,三行字能救一次夜班。
三、性能排查的五件套
负载高先看负载平均值和 CPU 百分比的关系,负载均值远高于核数、CPU 却不忙,多半是在排队等磁盘,这时候盯着 CPU 找问题是白费劲;内存看 available 而不是 free,Linux 会把空闲内存拿去做缓存,free 很小不代表内存不够;磁盘用 iostat 看利用率和等待时间,两个数一起高才是真瓶颈;vmstat 里 si、so 持续不为零说明在换页,内存已经吃紧;最后翻 dmesg 和日志,被内存保护机制杀掉的进程、硬盘报错、网卡丢包,全都在里面留着证据。
四、几个高频坑
一是进程莫名其妙消失,多半是被内存不足保护机制杀的,日志里搜一下就能确认,解决方向是加内存、限制应用内存或者加交换分区并调低主动杀进程的倾向;二是磁盘突然变慢,先查 RAID 是不是在后台重建,再看硬盘健康度,机械盘大量重映射扇区就是要挂的前兆;三是服务器时间不对,证书验证失败、日志对不上号都是它,把时间同步服务配好并且确认时区;四是连接数耗尽,服务看起来活着就是不响应,用连接统计工具数一下句柄,把文件句柄上限和应用端的连接复用调好。
五、调试纪律:先观察,再动手
服务器上的很多”优化”是把双刃剑,改内核参数、换调度器这类操作,没搞清楚机制之前别在跑业务的机器上做。正确的节奏是:先把现象和指标记录下来,在测试机复现,验证有效再上线,一次只改一个变量。改完没变化要回滚,别堆叠多个变更到最后分不清哪个起作用。
说到底,服务器调试拼的不是背命令,是习惯:入口永远留两条,操作永远可回滚,判断永远看证据。你们第一次接手服务器时踩过什么坑?有没有把自己锁在门外的经历,评论区聊聊。


没有回复内容